
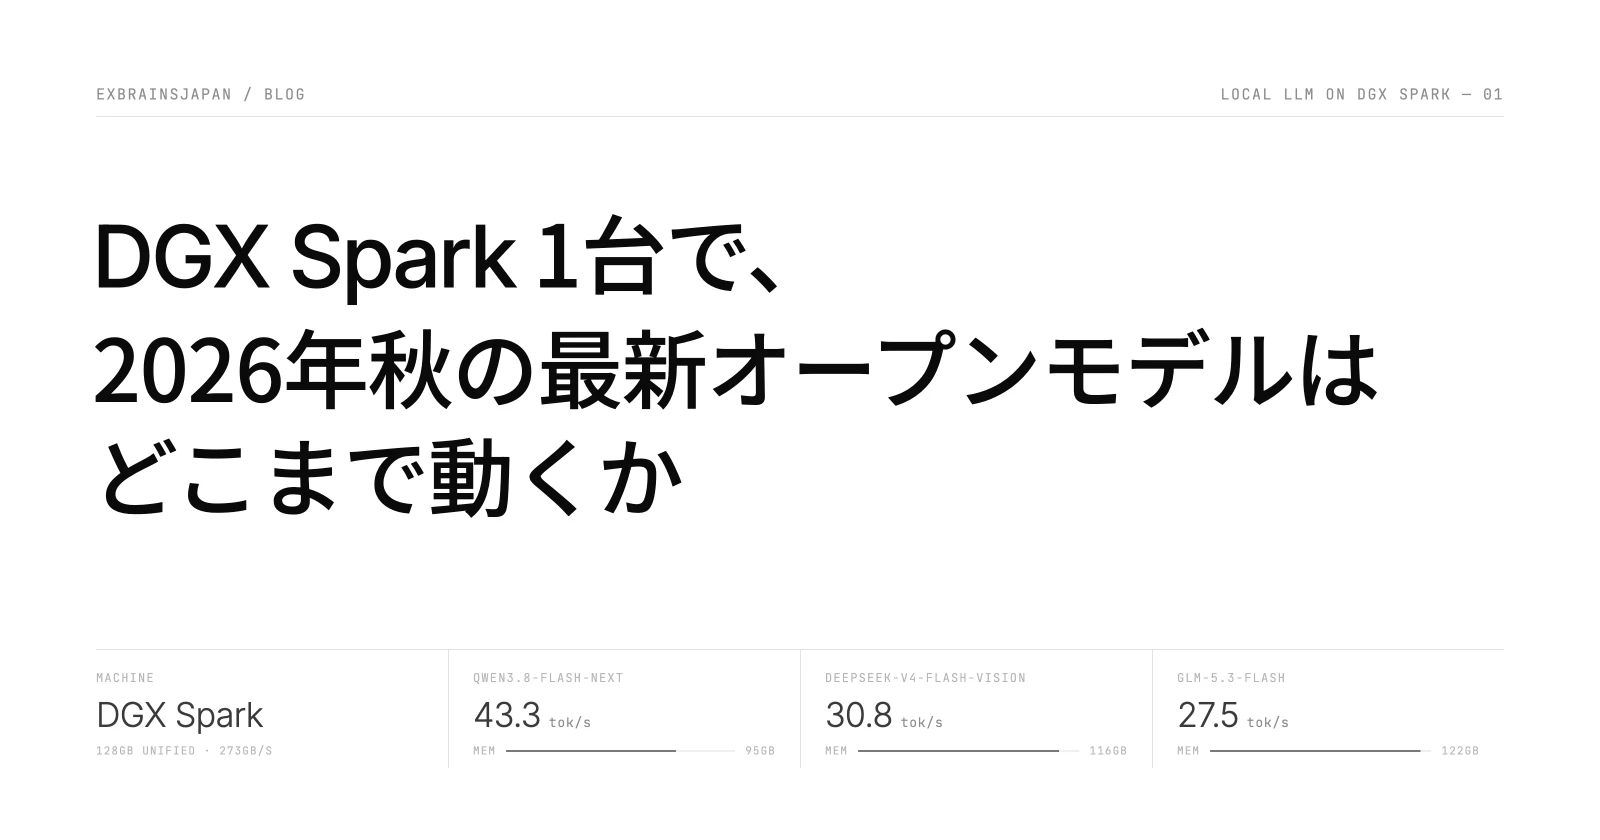
当社では、NVIDIA DGX Spark を1台導入し、ローカルLLMの実行環境を構築しております。本稿では、DeepSeek・GLM・Kimi・Qwen の4社が2026年秋の時点で公開している最新のオープンモデルについて、DGX Spark 1台で動かせるかを調査し、実際に3つのモデルを動かして計測した結果をご紹介いたします。
結論
- 各社の最新のフラッグシップモデル(総パラメータ数千億〜2.8兆)は、いずれも DGX Spark 1台には載りません。
- 1台で動かせるのは、主に各社が「Flash」の名前で公開している中型のモデルです。ただし DeepSeek の最新の V4.1-Flash は、名前に Flash と付いていても載りません。
- 実機では、Qwen3.8-Flash-Next(4bit)、GLM-5.3-Flash(2bit)、DeepSeek-V4-Flash-Vision-Exp(2bit)の3モデルが動作しました。生成速度は、投機的デコードを有効にして 27〜43 tok/s(1秒あたりの生成トークン数)です。
- 速度とメモリの余裕の両面で、普段使いには Qwen3.8-Flash-Next が最も適しています。
DGX Spark で効いてくる2つの制約
DGX Spark は、Grace CPU と Blackwell GPU を1つにまとめた NVIDIA GB10 を搭載する小型の AI コンピュータです。今回使用した機体の主な仕様は次のとおりです。
| チップ | NVIDIA GB10(Grace Blackwell)。CPU は arm64 の20コア |
|---|---|
| メモリ | 128GB の LPDDR5x を CPU と GPU で共有。GPU から実際に使えるのは約117〜121GB |
| メモリ帯域 | 273GB/s |
| ストレージ | NVMe SSD 4TB |
| OS | Ubuntu 24.04(NVIDIA ドライバと CUDA 13.0 は導入済み) |
LLM を動かすうえで効いてくる制約は、メモリの容量と帯域の2つです。
1つ目はメモリの容量です。モデルの重みと KV キャッシュ(会話の文脈を保持する領域)が、GPU から使える約117〜121GB に収まる必要があります。目安として、4bit に量子化したモデルで約2,000億パラメータ、2bit で約3,000億パラメータが上限となります。
2つ目はメモリ帯域です。文章の生成では、1トークンを出すたびに、その計算に使う重みをすべてメモリから読み出します。そのため、生成速度の上限はおおよそ次の式で見積もることができます。
生成速度の上限(tok/s)≈ 273GB/s ÷ 1トークンあたりに読み出す重みの量(GB)
たとえば、すべてのパラメータを毎回使う dense な 27B のモデルを 8bit で動かすと、1トークンあたり約27GB を読み出すため、上限は約10 tok/s です。一方、MoE(Mixture of Experts)構造で、1トークンあたりに使う「アクティブパラメータ」が 6B のモデルを 4bit で動かすと、読み出しは約3.5GB で、上限は約80 tok/s となります。
したがって DGX Spark には、総パラメータ数が大きくても、アクティブパラメータの小さい MoE モデルが適しています。
各社の最新モデルと、1台に載るかどうか
2026年10月15日時点で、各社が Hugging Face で公開している主なモデルを調査しました。「実機で確認」と記載したもの以外は、ファイルサイズと他の方の報告に基づく判定です。
| メーカー | モデル | 総パラメータ / アクティブ | DGX Spark 1台 |
|---|---|---|---|
| Qwen | Qwen3.8-2.4T-A95B | 2.4T / 95B | 載らない |
| Qwen | Qwen3.8-Flash-Next | 180B / 6B | 4bit で載る(実機で確認) |
| Qwen | Qwen3.8-27B | 27B(dense) | 8bit で載る(約30GB) |
| GLM | GLM-5.3 | 744B / 40B | 載らない |
| GLM | GLM-5.3-Flash | 321B / 18B | 2bit で載る(実機で確認) |
| GLM | GLM-4.7-Flash | 30B / 3B | 8bit で載る(約31GB) |
| DeepSeek | DeepSeek-V4-Pro-0813 | 1.6T / 49B | 載らない |
| DeepSeek | DeepSeek-V4.1-Flash | 552B + n-gram 埋め込み表 / 8〜16B | 載らない |
| DeepSeek | DeepSeek-V4-Flash-Vision-Exp | 284B / 約13B | 2bit で載る(実機で確認) |
| DeepSeek | DeepSeek-V4-Flash-0731 | 284B / 約13B | 2〜3bit で載る |
| Kimi | Kimi-K3 | 2.8T / 104B | 載らない |
| Kimi | Kimi-K2.7-Code | 1T / 32B | 載らない |
各社の最新のフラッグシップは、いずれも1台に載りません。たとえば GLM-5.3 は、最も小さい1bit の量子化版でも 216.7GB あり、DGX Spark で使えるメモリの2倍近くになります。Kimi は2025年10月の Kimi-Linear-48B-A3B 以降、小型のモデルを公開しておらず、最新世代には1台に載るモデルがありません。
なお、各社が公表しているベンチマークの値は、量子化する前のモデルのものです。DGX Spark で動かす 2bit・4bit の量子化版では、性能がそれより下がる点にご留意ください。
実機で3つのモデルを動かした結果
1台に載る候補のうち、各社の最新世代にあたる3モデルを実際に動かしました。実行には llama.cpp(llama-server)を、モデルには Unsloth が公開している量子化済みの GGUF ファイルを使用しています。
| Qwen3.8-Flash-Next | GLM-5.3-Flash | DeepSeek-V4-Flash-Vision-Exp | |
|---|---|---|---|
| 量子化 | 4bit(UD-Q4_K_XL) | 2bit(UD-Q2_K_XL) | 2bit(UD-Q2_K_XL) |
| ファイルサイズ | 111.3GB | 108.7GB | 96.8GB |
| 生成速度(先読みなし) | 26.9 tok/s | 18.5 tok/s | 20.1 tok/s |
| 生成速度(先読みあり) | 43.3 tok/s | 27.5 tok/s | 30.8 tok/s |
| 先読みの方式 | MTP | MTP | DSpark |
| メモリ使用量のピーク | 約95GB | 121.7GB | 116.2GB |
| 画像入力 | 可 | 可 | 可 |
生成速度は、コード・日本語の文章・推論(thinking)の3種類のプロンプトを temperature=0 で生成させたときの平均です。「先読みあり」は、投機的デコード(小さな予測器で先のトークンを予想し、本体のモデルでまとめて検証することで速くする手法)を有効にした値で、方式はモデルによって異なります。
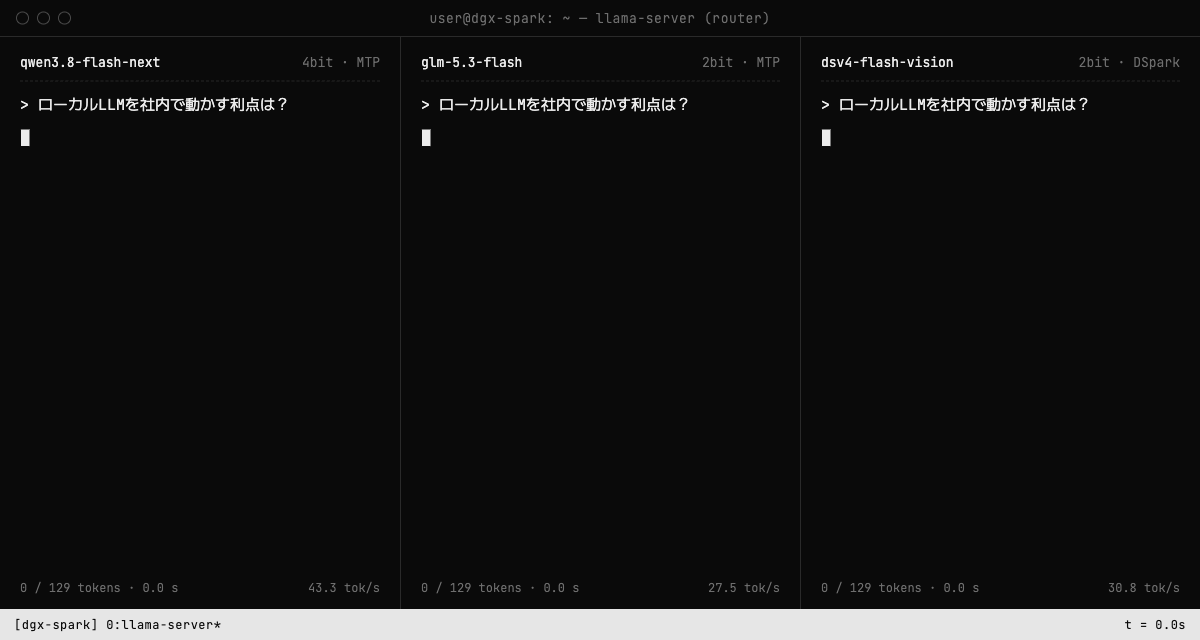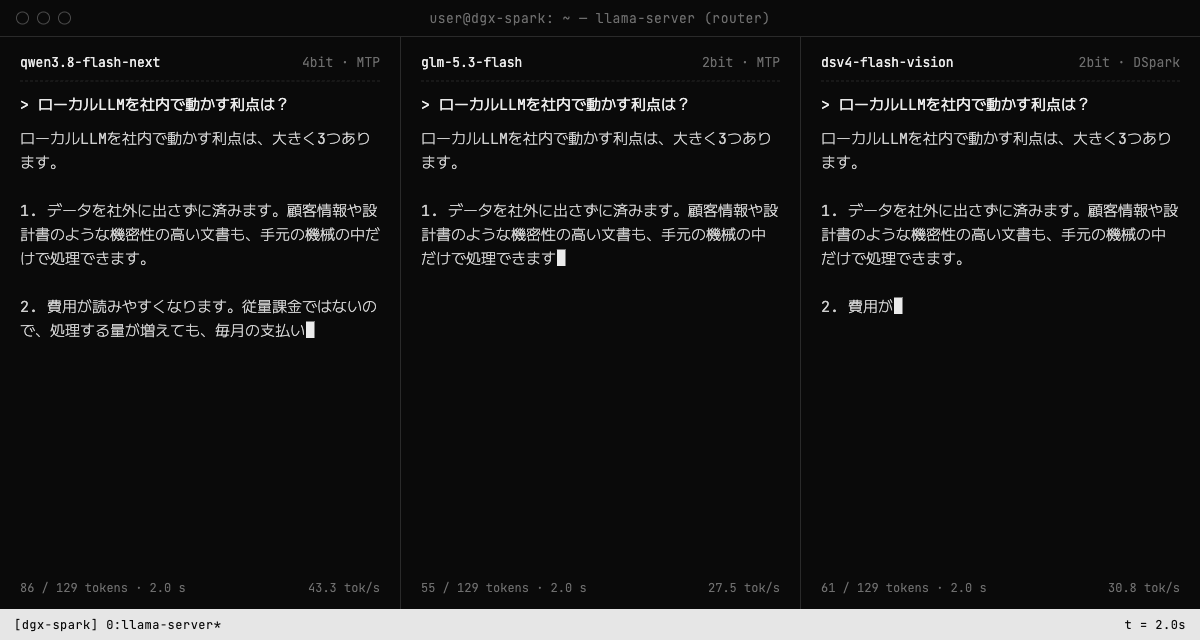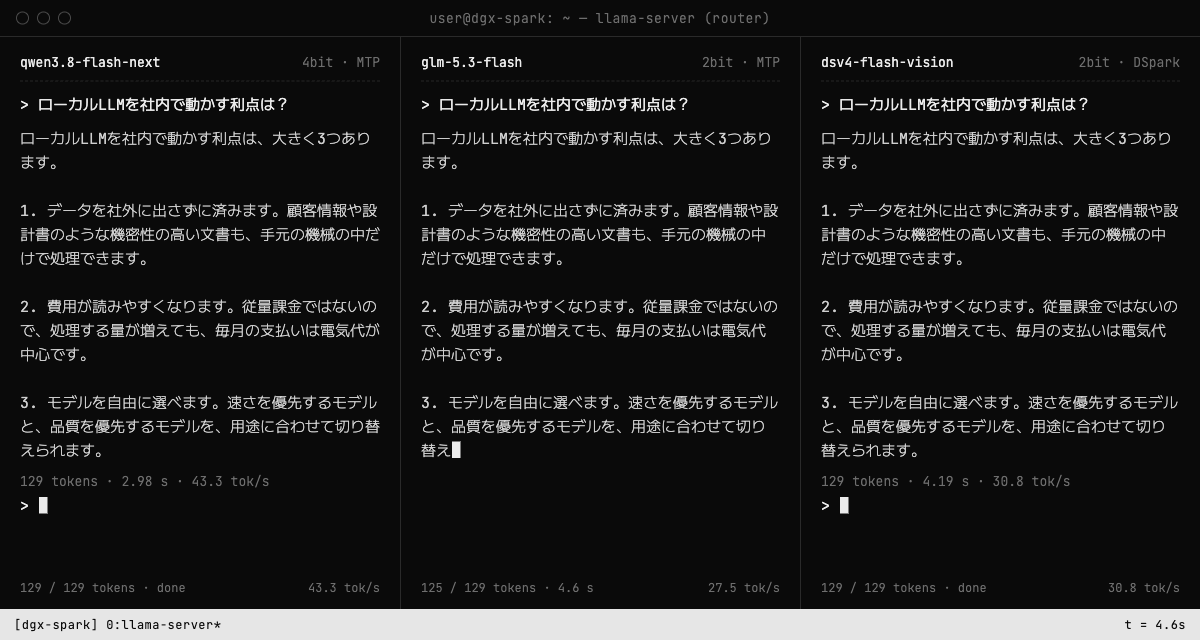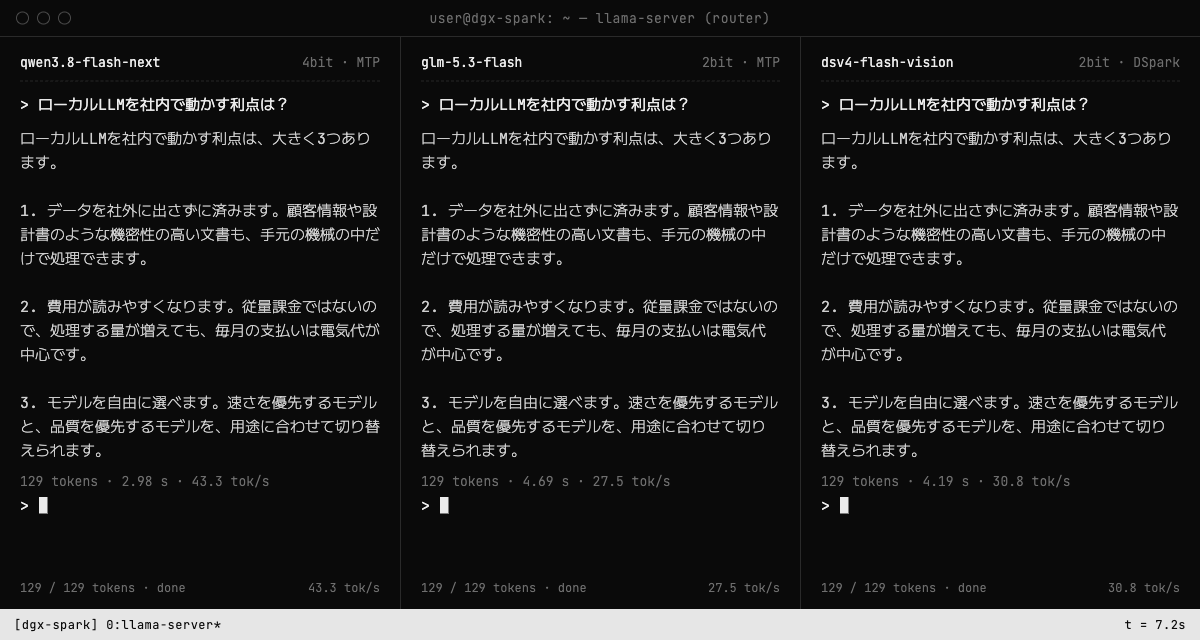
上の画像は、表の生成速度(先読みあり)で、3つのモデルが同じ回答を1トークンずつ書き出す様子を再現したものです。実際の画面を録画したものではなく、回答の文章も説明のために用意したものです。
結果から分かったことは次のとおりです。
- 速度はアクティブパラメータの順に並びました。先読みなしの速度は、Qwen3.8-Flash-Next(アクティブ 6B)、DeepSeek(約13B)、GLM(18B)の順で、前述の式のとおりの傾向です。ただし実測値は、式で見積もった上限(Qwen で約80 tok/s)を大きく下回っており、式はあくまで上限の目安です。
- Qwen3.8-Flash-Next はメモリに余裕があります。ファイルは 111.3GB ありますが、そのうち 51B パラメータ分の n-gram 埋め込み表は、必要な行だけを SSD から読み込む設定にできます。その結果、メモリ使用量は約95GB にとどまり、約30GB の空きが残りました。
- GLM-5.3-Flash はメモリをほぼ使い切ります。画像入力まで有効にするとピークは約124GB に達し、空きは 7GB を切りました。ほかの処理を並行して動かす余裕はほとんどありません。
- 2bit に量子化しても画像を読み取れました。3モデルとも、テスト画像に書かれた文字(請求書番号・品目・金額)と、図形の色・形を正しく答えています。
- DeepSeek は DGX Spark の仕様を誤って答えました。DGX Spark のメモリについて尋ねると、設定を変えても毎回「HBM3」など事実と異なる回答をしました(実際は LPDDR5x)。同じ質問に、ほかの2モデルは正しく答えています。
なお、各モデルの推奨設定(temperature 1.0)で実際にコードを書かせた場合は、先読みの予想が当たりにくくなるため、生成速度は 24〜31 tok/s 程度に下がりました。
1台に載らないモデルの扱い
- GLM-5.3:1台では動かせないため、GLM-5.3-Flash を使います。なお GLM-5.3-Flash については、DGX Spark を2台つなぎ、vLLM で4bit 相当(NVFP4)を動かす構成も報告されています。
- DeepSeek-V4.1-Flash:本体の 552B に加え、約200GB の n-gram 埋め込み表を持つモデルです。公開から1ヶ月以上が経過した時点でも llama.cpp 本体は対応しておらず、公開されている GGUF ファイルも最小で 169GB あります。1台で動かした報告は独自のエンジンによるもので、次のトークンの予測が元のモデルと一致する割合が 72.8〜82.3% にとどまるなど、品質か速度に大きな妥協があります。当社では llama.cpp 本体の対応を待ち、当面は1つ前の世代の V4-Flash-Vision-Exp を使用いたします。
- Kimi-K3 / Kimi-K2.7-Code:必要なメモリが 600GB〜1.5TB 級で、1台はもちろん2台でも動きません。
- Ollama で動かす場合:Ollama 公式の Qwen3.8-Flash-Next は MLX 形式のみで、MLX の実行環境が Linux arm64 向けに配布されていないため、DGX Spark では動きません。調査の範囲では、Ollama で手軽に動くのは Qwen3.8-27B の GGUF 版などに限られます。また、タグに
:cloudが付いたモデルはクラウドで実行されるため、ローカルでの実行を目的とする場合はご注意ください。
実行環境は llama.cpp に統一
1台に載る候補のモデルは、いずれも llama.cpp 本体で動作します。モデルごとに最も速いエンジン(ExLlamaV3、vLLM など)は異なりますが、エンジンごとに環境を構築・保守する手間を避けるため、当社では実行基盤を llama.cpp に統一いたしました。llama-server のルーターモードを使うと、3つのモデルを1つのサーバー・1つの API で切り替えて使えます(切り替えには1〜2分かかります)。
その代わり、新しいモデルへの対応の早さと、速度の一部を諦めることになります。たとえば Qwen3.8-Flash-Next は、専用のエンジン(ExLlamaV3)で約76 tok/s 出るという報告があります。
用途ごとのおすすめ
- 普段使い:Qwen3.8-Flash-Next。3モデルの中で最も速く、メモリにも余裕があります。当社で Vue・Nuxt のコードを書かせて比較した評価でも、テストと型チェックをすべて通過した回答が最も多いモデルでした(30回答中28回答)。
- コードの書き方の質を重視する場合:GLM-5.3-Flash。同じ評価で、コードの書き方の採点は3回とも最高でした。ただし型チェックで不合格になることが多く、メモリもほぼ使い切ります。
- 回答までの速さを重視する場合:DeepSeek-V4-Flash-Vision-Exp。考える量(thinking)が少なく、同じ課題を GLM の半分以下の時間で解き終えました。一方で、同じ知識の誤りを繰り返す傾向が見られました。
- 手軽さを重視する場合:Qwen3.8-27B。Apache-2.0 ライセンスで、Ollama でも動作します(今回は実機では試していません)。
なお、Qwen3.8-Flash-Next のライセンスは Apache-2.0 ではなく Qwen Community License 1.0 です。GLM-5.3-Flash と DeepSeek-V4-Flash-Vision-Exp は MIT ライセンスです。業務でご利用になる場合は、各ライセンスの条件をご確認ください。
調査の時点と参考資料
本稿の内容は、2026年10月15日〜16日時点の情報と、llama.cpp(ビルド b11644・b11681)による計測に基づいております。ローカルLLMをめぐる状況は変化が速く、モデルや実行環境の対応状況は短期間で変わる可能性があります。
- モデル:Qwen3.8-Flash-Next / GLM-5.3-Flash / DeepSeek-V4-Flash-Vision-Exp / DeepSeek-V4.1-Flash
- 量子化済みのファイル:unsloth/Qwen3.8-Flash-Next-GGUF / unsloth/GLM-5.3-Flash-GGUF / unsloth/DeepSeek-V4-Flash-Vision-Exp-GGUF / unsloth/GLM-5.3-GGUF
- 実行環境:llama.cpp
- DGX Spark での検証報告:Classmethod: GLM-5.3-Flash on a single DGX Spark / Classmethod: 2-node GLM-5.3-Flash NVFP4 vLLM / NVIDIA Developer Forums: DeepSeek V4.1 Flash on a Single DGX Spark
お問い合わせ
当社では、ローカルLLMの実行環境の選定・構築から、業務システムへの組み込み、導入後の運用までを一貫してお引き受けしております。機密性の高いデータを社外に出さずに AI を活用したい場合など、ご検討の初期段階からご相談を承っております。
お気軽にお問い合わせください。